Tous les modèles de langage sont européens de nos jours. Posez une question de plus et vous tombez sur un centre de données à Francfort exploité par une entreprise de Seattle. Quiconque prend des décisions sur l’IA générative cet automne entend partout les trois mêmes mots : ouvert, européen, souverain. Ce que ces mots signifient ? C’est le fournisseur qui en décide. Un rapport de l’organisme de recherche néerlandais TNO, publié en août 2026, pose désormais une référence claire à côté de ces termes [1, 2].
Pourquoi « ouvert » et « européen » apparaissent soudain partout
TNO a examiné, pour le compte du ministère néerlandais de l’Intérieur (BZK), ce que « ouvert » et « européen » signifient réellement pour les modèles de langage [1, 2]. Le déclencheur est géopolitique. La stratégie néerlandaise de numérisation exige davantage de maîtrise des dépendances numériques. Les modèles de langage constituent la couche la plus récente d’une chaîne logicielle qui se trouve déjà en grande partie hors d’Europe. La conclusion est nette. Il n’existe aucune définition univoque d’un modèle de langage « ouvert », et « européen » peut se lire d’au moins quatre façons [1]. Les fournisseurs en tirent habilement parti [1]. TNO parle d’« open-washing », d’« Europe-washing » et de « souveraineté-washing », et conseille aux administrations de fixer leurs propres définitions de travail avant le début des achats [1]. La scène est familière dans les communes et les organismes publics. L’acheteur demande si le modèle est ouvert ; le fournisseur acquiesce. Le RSSI demande où se trouvent les données ; silence. Les questions ci-dessous vous permettent de piloter cette conversation.
Ouvert est un spectre, pas un interrupteur
TNO distingue cinq degrés d’ouverture, dont trois sont courants en pratique [1] :
- Modèle fermé : vous l’utilisez uniquement via une API. Taille, données d’entraînement et traitement des données restent secrets (par exemple GPT d’OpenAI) [1].
- Modèle open-weight : vous recevez les poids du modèle [1]. Vous pouvez l’exécuter et l’affiner vous-même, mais vous ne voyez ni les données d’entraînement ni le processus (comme Llama et Mistral) [1].
- Modèle entièrement ouvert : publie aussi les données d’entraînement et le code source (comme le modèle suisse Apertus) [1].
La nuance cruciale se situe dans la catégorie intermédiaire. Open-weight, c’est ce que sont réellement la plupart des modèles « ouverts ». Cela a de la valeur : vous pouvez l’héberger vous-même et garder la maîtrise de vos données. Mais vous ne savez toujours pas précisément ce qu’il contient. Un fournisseur qui qualifie son modèle d’« open source » veut presque toujours dire open-weight. Question 1 : quel degré d’ouverture ce modèle a-t-il exactement, et que puis-je vérifier moi-même ?
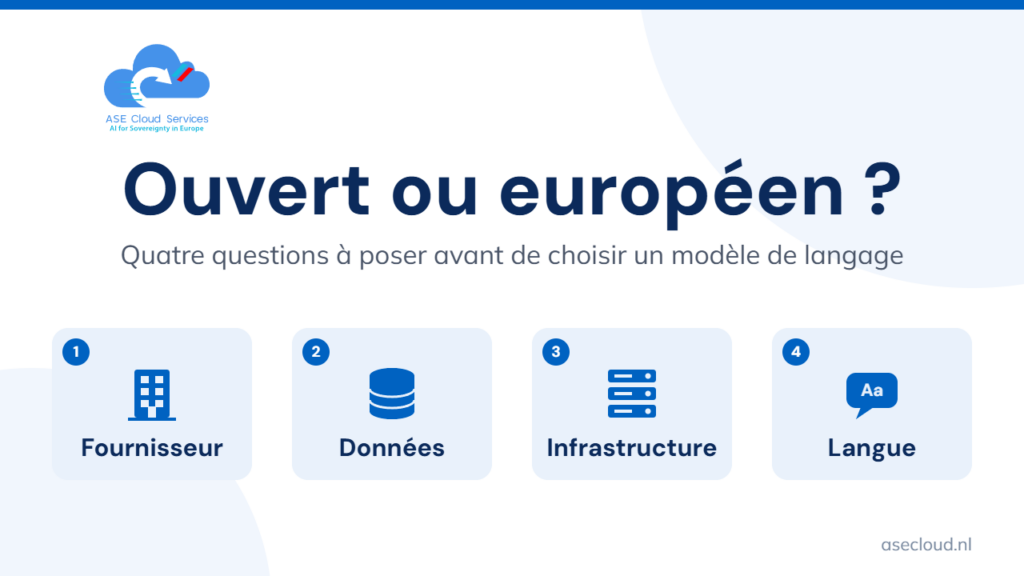
Un modèle de langage européen, ce sont quatre questions, pas une case à cocher
Dans son rapport, TNO utilise un tableau d’évaluation avec quatre critères distincts [1] :
- Origine du fournisseur : l’organisation relève-t-elle de la juridiction de l’EEE, ou d’une législation étrangère comme le CLOUD Act américain [1] ?
- Localisation des données : où les données sont-elles stockées et traitées [1] ?
- Infrastructure : sur quel matériel le modèle tourne-t-il [1] ?
- Base linguistique : le modèle a-t-il été entraîné de façon démontrable sur des langues européennes, dont la vôtre [1] ?
Un modèle d’une entreprise européenne sur un cloud américain n’est pas souverain, affirme TNO sans détour [1]. À l’inverse, un modèle européen ouvert ne garantit rien si le matériel vient des États-Unis [1]. De plus, un modèle n’est pas encore une application : le chatbot que vous utilisez se compose de toute une chaîne [1]. Posez donc ces quatre questions à l’ensemble de la chaîne. Où se trouve l’organisation ? Où sont les données ? Où cela tourne-t-il ? Le modèle a-t-il été délibérément entraîné sur votre langue, ou la connaît-il par hasard ? Un fournisseur qui apporte de la clarté sur les quatre points est rare. Un fournisseur qui hésite sur un point vous montre immédiatement où se situent les risques.
Nos propres choix, et leur revers
Un récit sur des choix clairs ne fonctionne que si nous mettons nos propres cartes sur la table. La plateforme IA IRIS d’ASE Cloud Services tourne sur Mistral Small, un modèle open-weight sous licence Apache 2.0 d’une entreprise française. Sur les quatre questions de TNO, cela donne : fournisseur dans l’EEE, stockage des données dans notre propre environnement cloud chez OVHcloud (Gravelines et Strasbourg), infrastructure au sein de l’UE et entraînement sur des langues européennes. Mais TNO nomme aussi les risques de ce choix précis [1]. Mistral propose des modèles open-weight avec une visibilité limitée sur les données d’entraînement, et il existe un risque permanent de rachat par des investisseurs non européens [1]. Ce risque, vous l’absorbez dans l’architecture autour du modèle. Le modèle lui-même a été rendu remplaçable. La base de connaissances du client se trouve dans une couche RAG isolée, aucun entraînement n’est effectué sur les données des clients et tout repose sur des standards ouverts. Changez de modèle, et la base de connaissances reste simplement en place. Comme le modèle est open-weight, c’est le client qui choisit l’environnement d’exécution. Nous livrons l’application en quatre variantes : via l’API Mistral, dans notre cloud européen, dans l’environnement cloud du client, ou sur site. Ce choix appartient à l’organisation, pas au fournisseur. C’est ainsi que vous évitez la dépendance à un fournisseur. Qui garde la maîtrise des données, de l’hébergement et de la couche applicative change facilement dès qu’un meilleur modèle apparaît.
Le plus petit premier pas
Il n’est pas nécessaire de migrer tout de suite. Emportez ces quatre questions à votre prochain entretien avec un fournisseur et posez-les aussi à vos fournisseurs actuels. Consignez les réponses, sources comprises. C’est immédiatement le dossier pour la direction, les achats et les autorités de contrôle, et cela pose la base de la définition de travail que TNO recommande [1]. Le tableau d’évaluation de TNO est accessible publiquement sur open.overheid.nl [2]. Vous souhaitez appliquer ces questions à votre situation ? Lors d’une consultation gratuite de 30 minutes, nous passons les options en revue. Consultez nos services de conseil en IA pour en savoir plus. Si vous souhaitez d’abord vérifier que votre gouvernance de l’IA peut porter le choix d’un modèle, l’Évaluation GAP le cartographie en 40 à 60 heures. Et pour faire travailler le modèle choisi directement sur vos propres documents, il y a l’Assistant IA pour l’espace de travail.
Sources
- TNO (2026). Open en Europese taalmodellen bij de overheid: definities en afwegingen (Modèles de langage ouverts et européens dans l’administration : définitions et arbitrages). Rapport TNO-2026-17545, août 2026 (en néerlandais). https://open.overheid.nl/details/6ba92fae-f8e6-48f0-a5d2-bf334b14ac5e
- Digitale Overheid (2026). Verkenning inzet open en Europese taalmodellen bij overheid, 1er septembre 2026 (en néerlandais). https://www.digitaleoverheid.nl/nieuws/verkenning-inzet-open-en-europese-taalmodellen-bij-overheid/

